Öne çıkan bulgular
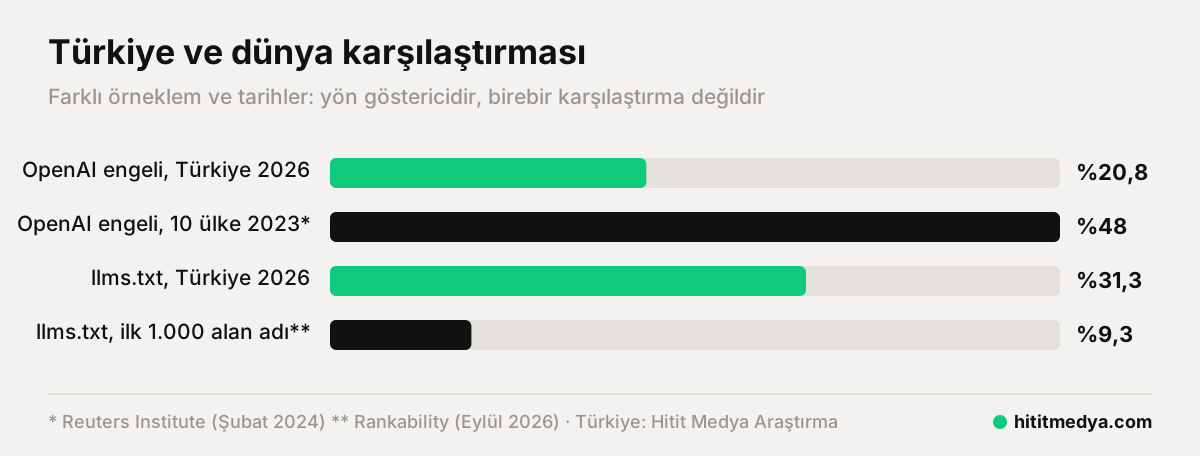
- İncelenen 48 ulusal haber sitesinden 10'u (%20,8) OpenAI botlarını robots.txt ile engelliyor. Reuters Institute'un 10 ülkede aynı tanımla yaptığı ölçümde bu oran 2023 sonunda %48'di.
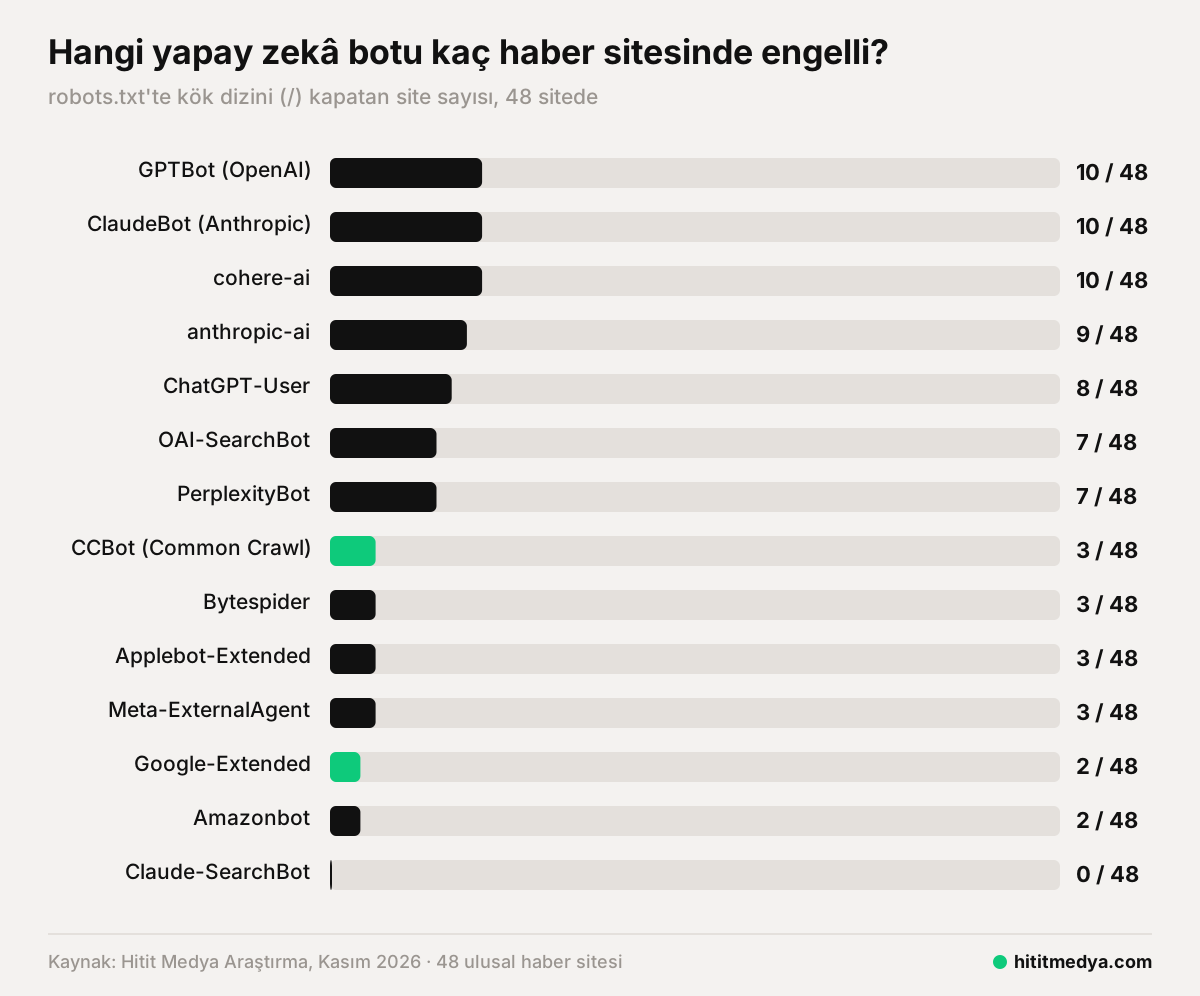
- Engelleyen 10 sitenin 7'sinde robots.txt'teki yapay zekâ listesi birebir aynı: aynı 7 bot, aynı sırayla. Bu listede Common Crawl (CCBot) ve Google-Extended yok.
- Google'ın yapay zekâ eğitimi için ayrı tuttuğu Google-Extended yalnızca 2 sitede, pek çok dil modelinin eğitim verisine kaynaklık eden CCBot 3 sitede engelli.
- Engelleyen sitelerin 8'i yalnızca eğitim botlarını değil, ChatGPT ve Perplexity'nin arama ve kullanıcı botlarını da kapatıyor.
- 15 site (%31,3) llms.txt yayımlıyor. Dünyanın en çok ziyaret edilen 1.000 alan adında bu oran %9,3.
- Yalnızca dijital yayın yapan 11 sitenin hiçbiri yapay zekâ botu engellemiyor, 5'i llms.txt yayımlıyor.
- Botları engelleyen siteler ile llms.txt yayımlayan siteler arasında hiç kesişim yok: sektör iki kampa ayrılmış, 23 site ise henüz bir tavır belirlememiş.
Bu araştırma neden yapıldı?
Yapay zekâ şirketleri, modellerini eğitmek ve arama yanıtlarında kaynak göstermek için web'i botlarla tarıyor. Haber yayıncıları için soru basit: içeriğim bu sistemlere girsin mi? Bu kararın en görünür izi, her sitenin kökünde duran ve botlara hangi bölümlere girebileceklerini söyleyen robots.txt dosyası.
Reuters Institute, Şubat 2024'te 10 ülkenin en çok okunan haber sitelerinde bu dosyaları inceledi ve 2023 sonunda sitelerin %48'inin OpenAI botlarını engellediğini buldu. Türkiye o çalışmada yoktu. Türkçe haber siteleri için güncel ve tekrarlanabilir bir ölçüm bulamadık. Bu rapor o boşluğu doldurmak için hazırlandı.
Bulgu 1: Türk haber siteleri botlara büyük ölçüde açık
Ölçülen 48 sitenin 10'u OpenAI'nin GPTBot ya da ChatGPT-User botunu engelliyor (%20,8). Reuters Institute'un tanımını birebir kullandık: bir site GPTBot'u, ChatGPT-User'ı ya da tüm botları engelliyorsa "OpenAI'yi engelliyor" sayıldı. Örneklemlerimiz ve tarihlerimiz farklı olduğu için bu bir yön göstergesi, birebir karşılaştırma değil. Yine de fark belirgin.
Engel oranı yayın türüne göre de değişiyor. Gazetelerin 20'de 5'i, TV kanallarının 13'te 4'ü engelliyor. Yalnızca dijital yayın yapan 11 sitenin hiçbiri engellemiyor.
Bulgu 2: Kopyala yapıştır robots.txt
Engelleyen 10 sitenin 7'sinde (Hürriyet, Milliyet, Posta, Fanatik, CNN Türk, NTV, NTV Spor) yapay zekâ bölümü birebir aynı: GPTBot, ChatGPT-User, OAI-SearchBot, ClaudeBot, anthropic-ai, PerplexityBot ve cohere-ai. Bu siteler iki farklı yayın grubuna ait. Ortak bir şablonun ya da altyapı sağlayıcısının izini taşıyor olabilir.
Aynı listede olmayanlar daha dikkat çekici:
- CCBot (Common Crawl): Common Crawl, web'in büyük bir bölümünü düzenli olarak arşivleyen ve pek çok dil modelinin eğitim verisine kaynaklık eden açık bir veri setidir. Bir site OpenAI'nin botunu engelleyip CCBot'a açık kalırsa, içeriği bu arşiv üzerinden yine eğitim verisine girebilir.
- Google-Extended: Google'ın Gemini gibi ürünlerde içeriğin eğitim ve yanıt üretiminde kullanılmasını kontrol etmek için sunduğu ayrı bir işarettir. Google arama sıralamasını etkilemez. Listede olmaması, bu sitelerin içeriğinin Google'ın yapay zekâ ürünlerine açık kaldığı anlamına gelir.
- Claude-SearchBot: Anthropic'in arama için kullandığı bu yeni bot, ölçülen hiçbir sitede adıyla engellenmiyor. Robots.txt listeleri yazıldıkları tarihte donup kalıyor.
Bulgu 3: Eğitim botu ile arama botu ayrımı yapılmıyor
Yapay zekâ botları iki farklı iş yapıyor. Bir kısmı (GPTBot, ClaudeBot, CCBot) model eğitimi için veri topluyor. Diğerleri (OAI-SearchBot, ChatGPT-User, PerplexityBot) kullanıcı bir soru sorduğunda sayfayı okuyup yanıtta kaynak olarak bağlantı veriyor. İkinci grubu engellemek, bu sistemlerin yanıtlarında kaynak gösterilme ve oradan trafik alma ihtimalini de azaltıyor.
Engelleyen 10 sitenin 8'i arama ya da kullanıcı botlarından en az birini de kapatıyor. Yalnızca eğitim botlarını hedefleyen ayrımlı bir politika 2 sitede (Cumhuriyet ve İHA) görülüyor.
Bulgu 4: llms.txt beklenenden yaygın
llms.txt, sitenin içeriğini dil modellerine özetleyen, Eylül 2024'te önerilmiş bir metin dosyası. Henüz bir standart kuruluşunca kabul edilmiş değil ve büyük yapay zekâ şirketlerinin bu dosyayı nasıl kullandığı açıkça beyan edilmiyor. Buna rağmen ölçülen sitelerin 15'i (%31,3) bu dosyayı yayımlıyor: Sabah, Sözcü, Takvim, Akşam, Yeni Akit, Karar, Fotomaç, A Haber, TGRT Haber, A Spor, En Son Haber, Haberler.com, Son Dakika, Mynet, Diken.
Dosyaların hepsini tek tek açtık. Hepsi gerçek içerik barındırıyor. Bir kısmı elle yazılmış kısa site tanıtımları, en az biri ise bir WordPress SEO eklentisinin otomatik ürettiği büyük bir liste.
Bulgu 5: İki kamp, kesişim yok
Botları engelleyen 10 site ile llms.txt yayımlayan 15 site arasında hiç ortak site yok. Bir grup yayıncı yapay zekâ sistemlerine kapıyı kapatırken, diğer grup bu sistemlere içeriğini nasıl okuyacaklarını anlatan bir rehber bırakıyor. Kalan 23 site ise robots.txt'te yapay zekâ botlarından hiç söz etmiyor ve llms.txt de yayımlamıyor.
Yayıncılar için ne anlama geliyor?
- Eğitim ve arama botlarını ayrı değerlendirin. Amaç içeriğin model eğitiminde kullanılmasını sınırlamaksa, arama botlarını engellemek yapay zekâ yanıtlarındaki kaynak bağlantılarını da kaybettirebilir.
- CCBot ve Google-Extended'i unutmayın. Bir engelleme politikası varsa, bu iki işaret olmadan eksik kalır.
- Listeyi yılda en az bir kez güncelleyin. Yeni botlar çıkıyor, isimler değişiyor.
- robots.txt bir rica, bir kilit değil. Kurallara uymayan botlara karşı sunucu ya da CDN düzeyinde önlem gerekir.
Yöntem
Örneklem: Türkiye'de ulusal yayın yapan 50 haber sitesi. Liste 20 gazete, 13 TV kanalı, 4 haber ajansı ve 13 yalnızca dijital yayın yapan siteden oluşuyor ve tamamı aşağıdaki tabloda yer alıyor. Bu bir trafik sıralaması değil, bilinirliği yüksek ulusal yayıncılardan oluşan beyan edilmiş bir listedir.
Tarih: Veriler 10 Kasım 2026'da toplandı.
Ölçüm: Her sitenin ana sayfası, /robots.txt ve /llms.txt dosyaları açık bir tarayıcı kimliğiyle (HititMedyaResearch/1.0), sırayla ve aralarında bekleme bırakılarak bir kez istendi. robots.txt dosyaları user-agent gruplarına ayrıldı. Bir bot için kendi adını taşıyan grup varsa o grubun kuralları, yoksa "*" grubunun kuralları uygulandı. Kök dizini (/) kapatan bir Disallow kuralı "engel" sayıldı. Kısmi engeller (yalnızca bazı klasörler) engel sayılmadı. llms.txt, HTML olmayan ve gerçek içerik taşıyan bir yanıt döndüğünde "var" kabul edildi.
İncelenen botlar (14): GPTBot, ChatGPT-User, OAI-SearchBot, ClaudeBot, Claude-SearchBot, anthropic-ai, Google-Extended, CCBot, PerplexityBot, Bytespider, Applebot-Extended, meta-externalagent, Amazonbot, cohere-ai.
Kapsam dışı kalanlar: T24'e bağlantı kurulamadı, Medyascope ise robots.txt dahil tüm isteklerimize bot doğrulama sayfası döndürdü. Bu iki site oranlara dahil edilmedi, ölçülen site sayısı 48. DHA'nın robots.txt dosyası yok (404). Bu durumda tüm botlar izinli kabul edildi.
Sınırlar: Bu çalışma yalnızca robots.txt'te yazılı tercihi ölçer. Sunucu ya da CDN düzeyinde uygulanan bot engellerini ölçmez. Nitekim iki site (İHA ve En Son Haber) ana sayfa isteğimize 403 döndürdü. Reuters Institute karşılaştırması farklı ülke, site ve tarihleri kapsar.
Verileri kullanın
Tüm veriler CSV olarak indirilebilir ve kaynak gösterilerek serbestçe kullanılabilir (CC BY 4.0). Grafikleri sitenize eklemek için aşağıdaki kodları kullanabilirsiniz.
Bot bazında engelleme grafiği:
<a href="https://www.hititmedya.com/tr/analizler/turk-haber-siteleri-yapay-zeka-botlari-arastirmasi-2026"><img src="https://www.hititmedya.com/data/arastirma/haber-ai-botlari-bot-bazinda-tr.svg" alt="Hangi yapay zekâ botu kaç Türk haber sitesinde engelli" width="1200" style="max-width:100%;height:auto"></a>
<p>Kaynak: <a href="https://www.hititmedya.com/tr/analizler/turk-haber-siteleri-yapay-zeka-botlari-arastirmasi-2026">Hitit Medya Araştırma</a></p>
Türkiye ve dünya karşılaştırması:
<a href="https://www.hititmedya.com/tr/analizler/turk-haber-siteleri-yapay-zeka-botlari-arastirmasi-2026"><img src="https://www.hititmedya.com/data/arastirma/haber-ai-botlari-karsilastirma-tr.svg" alt="Türk haber siteleri ve yapay zekâ botları: Türkiye ve dünya karşılaştırması" width="1200" style="max-width:100%;height:auto"></a>
<p>Kaynak: <a href="https://www.hititmedya.com/tr/analizler/turk-haber-siteleri-yapay-zeka-botlari-arastirmasi-2026">Hitit Medya Araştırma</a></p>
Bu çalışmayı her yıl aynı yöntemle ve aynı adreste güncellemeyi planlıyoruz. Hata ya da eksik gördüğünüz bir site varsa bize yazın.
Kaynaklar
- Fletcher, R. (2024). How many news websites block AI crawlers? Reuters Institute for the Study of Journalism.
- Rankability. llms.txt adoption (18 Eylül 2026 taraması, Tranco ilk 1.000 alan adı).
- llmstxt.org: llms.txt önerisi.
- RFC 9309: Robots Exclusion Protocol.